Zweite Runde: sechs weitere Iterationen für die erste Quelle, lange Quellen und sichtbare Grenzen
Aktualisierung vom 11. November 2026, zweite Runde. Sechs weitere Iterationen, erneut mit spezialisierten Subagenten, haben an dem gearbeitet, was Lesende zuerst erleben: die zuerst gelistete Quelle, Fakten am Ende sehr langer Quellen, eine klare Aussage darüber, was nicht gelesen wurde, und die lokale Latenz. Dieselben 96 zweisprachigen Modulfragen und 1.037 Endpunktabschnitte wurden erneut abgespielt; die Langquellenstudie wuchs von 96 auf 144 kontrollierte Fälle bis 1.024.000 Zeichen. Alles Folgende ist eine lokale Diagnose, keine Antwortkorrektheit, keine Nutzerstudie und kein Beleg für den besten Agenten.
BM25-Messgröße | Erste Runde | Zweite Runde |
|---|---|---|
Modultreffer unter den ersten vier (erste Wiederholung) | 96/96 | 96/96 |
Modultreffer an erster Stelle (Hit@1) | 74/96 | 77/96 |
MRR der ersten Modulquelle | 0,872 | 0,891 |
Rangverluste je Frage | – | 0 |
Lokale p50 / p95, 288 Läufe | 18,287 / 21,482 ms | 9,982 / 13,067 ms |
Kalter Cache | – | 31,067 ms (1 Lauf) |
Fehlgeschlagene Läufe, verlorene oder unaufgelöste Markierungen | 0 | 0 |
Hit@1 und MRR sind neu: Positionseffekte machen die zuerst gelistete Quelle am wichtigsten (Craswell et al., WSDM 2008). Der Gewinn kommt aus der BM25F-Titelgewichtung (Robertson, Zaragoza und Taylor, CIKM 2004), Gewicht 2,5 aus einem stabilen Plateau, ohne dass eine Frage ihre Modulquelle schlechter platziert als zuvor. Der Laufzeitgewinn kommt aus einem begrenzten Cache für Dokument-Tokenstatistiken (20.000 Einträge, 64 MiB Text, identische Scores kalt und warm; Robertson und Zaragoza, 2009). Hash-Vektoren bleiben unverändert bei 74/96; ihr p95 bewegte sich ohne Codeänderung um +0,45 % und wird dieser Runde nicht zugeschrieben. Die Zeiten stammen von einer Workstation ohne Modellaufrufe und Produktions-I/O und werden an der 0,1-Sekunden-Wahrnehmungsschwelle von Card, Robertson und Mackinlay, CHI 1991 gelesen, nicht als Servicezusage.
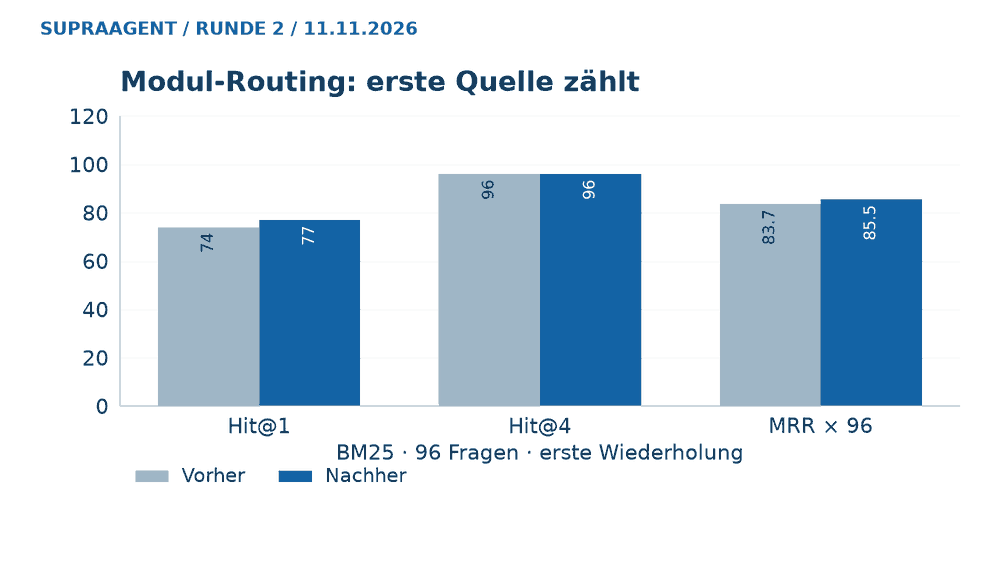
1. Modul-Routing: die erste Quelle zählt. BM25, 96 Fragen, erste Wiederholung.
Lange Quellen: Fakten am Ende gehen nicht mehr verloren, und die Antwort nennt, was übersprungen wurde
Quellenlänge (Zeichen) | Fakten im Prompt, vorher → nachher | Fakten in der deterministischen Antwort, vorher → nachher |
|---|---|---|
8.000 | 12/12 → 12/12 | 12/12 → 12/12 |
32.000 | 12/12 → 12/12 | 12/12 → 12/12 |
128.000 | 12/12 → 12/12 | 12/12 → 12/12 |
256.000 | 8/12 → 12/12 | 8/12 → 12/12 |
512.000 | 4/12 → 12/12 | 4/12 → 12/12 |
1.024.000 | 4/12 → 12/12 | 4/12 → 12/12 |
Der vollständige Scan bleibt bei 200.000 Zeichen begrenzt. Dahinter segmentiert der Packer jetzt höchstens sechzehn begrenzte Fenster von 8.192 Zeichen beiderseits ganzwörtiger Treffer der Frageterme, seltenster Term zuerst, verwirft jeden Satz am Fensterrand und führt Klammerkontexte über die Lücken weiter. Jede erreichte Grenze ist eine benannte Auslassung im Provider-Prompt. Fakten am Anfang, in der Mitte und am Ende bleiben in allen 72 positiven Fällen auf Deutsch und Englisch erhalten, wie von Lost in the Middle (Liu et al., TACL 2024) motiviert. Die 36 Kontrollen mit überlangen Verneinungen legen nie ein losgelöstes Prädikat frei, keine eingeschleuste Anweisung wird projiziert, und fehlende Fakten erzeugen keine Falschtreffer, weder im Prompt noch in der Antwort. Die Integration zeigte, dass die Grounding-Prüfung zitierte Zahlen weiterhin nur gegen die ersten 200.000 Zeichen prüfte und jeden Fakt aus dem hinteren Teil mit einem Ausweichsatz ablehnte; sie liest jetzt dieselben fragebezogenen Fenster, weshalb die Antwortspalte der Promptspalte entspricht.
Messgröße (144 Fälle × 3 Wiederholungen) | Vorher | Nachher |
|---|---|---|
Hinweis in der Antwort bei Quellen über 200.000 Zeichen | 0/72 | 72/72 |
Falsche Hinweise bei Quellen bis 200.000 Zeichen | 0 | 0 |
Prompt-Vorbereitung p50 / p95 | 24,360 / 38,115 ms | 18,367 / 38,923 ms |
Deterministische Antwort p50 / p95 | 126,091 / 280,828 ms | 119,871 / 374,552 ms |
Prompt-Vorbereitung p50 bei 256.000 Zeichen | 35,60 ms | 27,45 ms |
Deterministische Antwort p50 bei 1.024.000 Zeichen | 212,24 ms | 295,72 ms |
Die deterministische Antwort beginnt jetzt mit einem lokalisierten Satz, sobald eine Quelle nur teilweise durchsucht wurde, nach den Richtlinien G2 und G11 von Amershi et al., CHI 2019; der Hinweis enthält keine Quellenmarkierung und wird als Zeichenkette geprüft, nicht in einer Nutzerstudie. Der Packer-Umbau liefert auf 360 zufälligen Korpora und dem gesamten Raster byteidentische Ergebnisse zum archivierten Packer und macht den 200.000-Zeichen-Scan 2,9-mal schneller. Der Antwortpfad ist bei 1.024.000 Zeichen langsamer als zuvor, weil Packer, Attributionsprüfung und Grounding-Prüfung die hinteren Fenster jeweils selbst durchsuchen; er liefert dafür den Fakt statt eines Ausweichsatzes. Korrektheit und Quellenstützung bleiben getrennte Fragen (Gao et al., EMNLP 2023); Längen sind Zeichen, keine Token, und Modellverständnis wird nicht gemessen (Bai et al., ACL 2024).
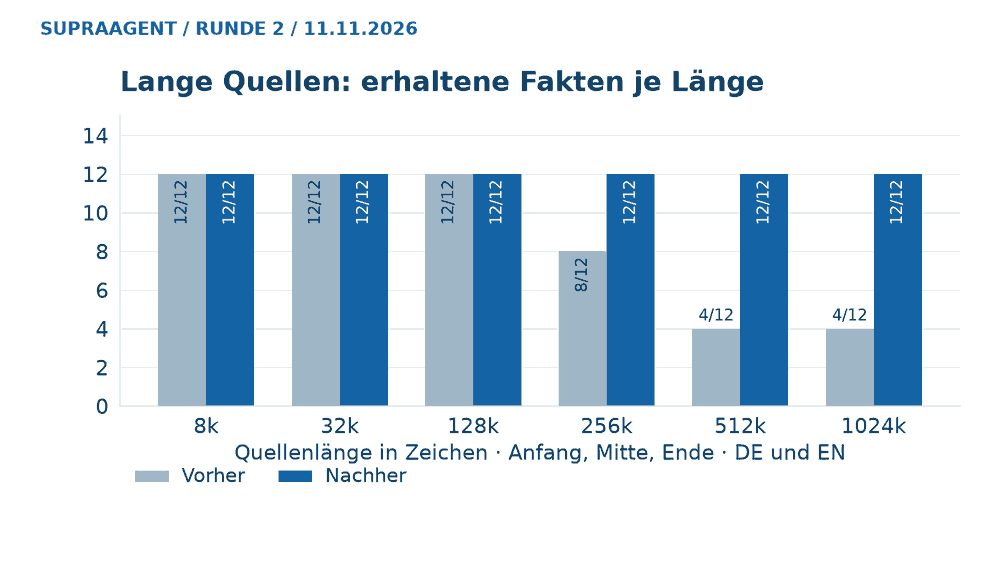
2. Lange Quellen: erhaltene Fakten je Länge, Anfang, Mitte und Ende, Deutsch und Englisch.
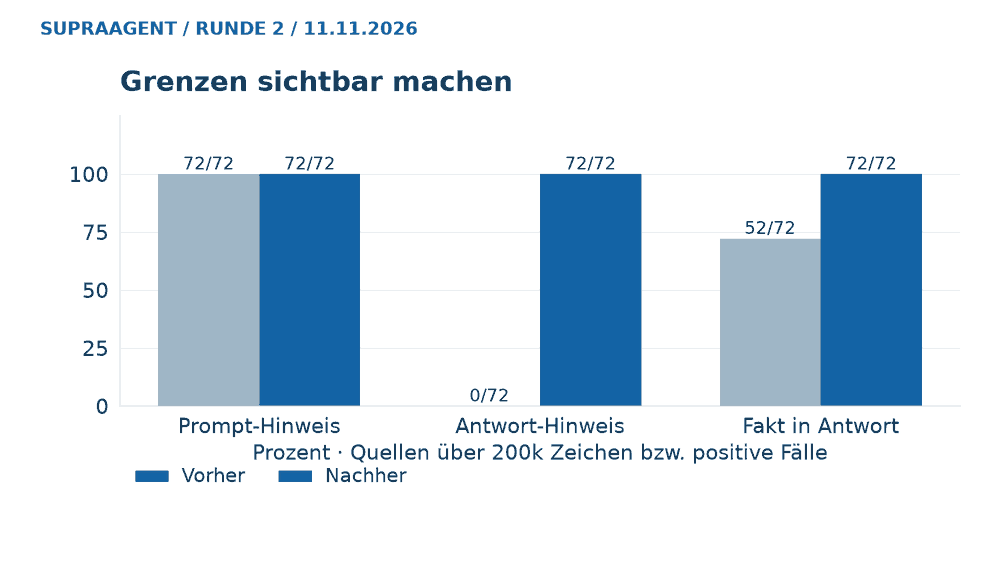
3. Grenzen sichtbar machen: Prompt-Hinweis, Antwort-Hinweis und Fakt in der Antwort.
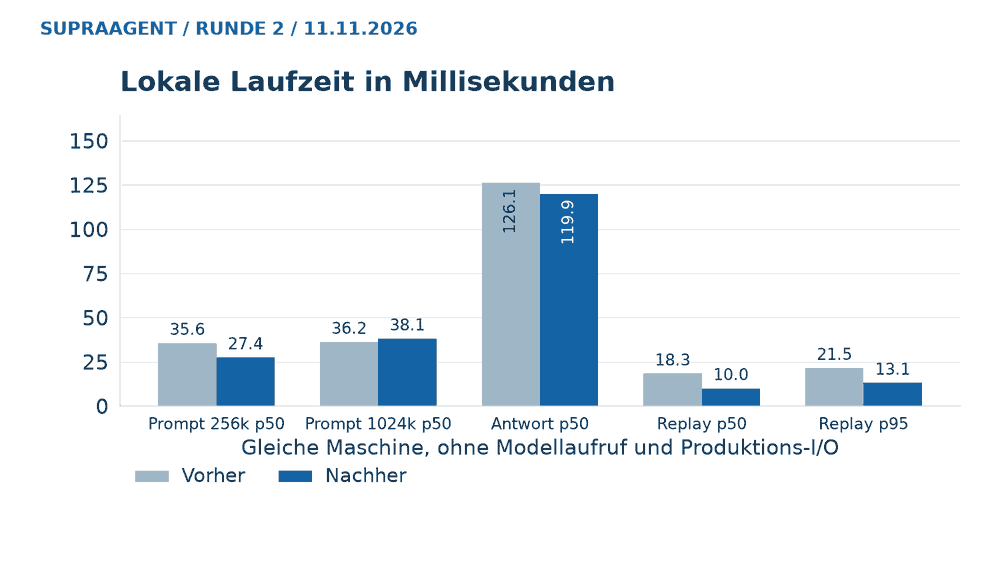
4. Lokale Laufzeit in Millisekunden, gleiche Workstation, ohne Modellaufruf und Produktions-I/O.
Was die zweite Runde der Reihe nach verändert hat: frische Ausgangsmessung und neue Messgrößen für erste Quelle, Cache und Antwortebene; Packer-Leistung mit byteidentischer Ausgabe; der fragebezogene Scan des hinteren Teils; BM25F-Titelgewichtung; der begrenzte Tokenstatistik-Cache; Hinweis auf Antwortebene plus Korrektur der Grounding-Prüfung, mit vollständigem Gate, 1.133 fokussierten Tests und komplettem Replay auf dem finalen Code. Eine getestete Abkürzung, das Filtern der Präposition „vor", wurde verworfen, weil das Projekt zeitliche Wörter bewusst durchsuchbar hält. Berichte, archivierte Quellen, Rohantworten und Abbildungen liegen im Nachweispaket der zweiten Runde (GitHub-Zugang erforderlich); jede zitierte DOI wurde über Crossref verifiziert.
Sechs Verbesserungsiterationen: die akzeptierten Ergebnisse
Aktualisierung vom 11. November 2026. Sechs Iterationen mit drei spezialisierten Subagenten haben den lokalen Benchmark und seine Nachweisprüfungen verbessert. Der akzeptierte BM25-Kandidat findet bei 96/96 statt zuvor 93/96 Fragen eine Quelle aus dem angefragten Modul unter den ersten vier Treffern. Gemessen wird die Modulzuordnung; unabhängige Antwortqualität und Nutzerzufriedenheit bleiben ungemessen.
BM25-Messgröße | Frische Ausgangsmessung | Akzeptierter Kandidat |
|---|---|---|
Modultreffer unter den ersten vier | 93/96 | 96/96 |
Deutsche Fragen | 45/48 | 48/48 |
Supportfragen | 21/24 | 24/24 |
Lokale p50-Laufzeit | 19,488 ms | 18,165 ms |
Lokale p95-Laufzeit | 23,229 ms | 21,152 ms |
Antworten mit Quellenmarkierungen | 95/96 | 96/96 |
Jeder vollständige Replay umfasst 576 Durchläufe: 96 Fragen × zwei Abrufverfahren × drei Wiederholungen auf denselben 1.037 Endpunktabschnitten. Der finale Kandidat hat keine fehlgeschlagenen Durchläufe und verliert gegenüber der Ausgangsmessung in keinem gepaarten Durchlauf einen Modultreffer oder vorhandene Quellenmarkierungen. BM25 erreicht über alle Wiederholungen 288/288 Modultreffer; sämtliche 927 beobachteten numerischen Quellenmarkierungen verweisen auf zugelassene Quellen-IDs. Das belegt keine semantische Quellenstützung. Die beobachtete p95-Reduktion beträgt 8,94 %. Die lokale Laufzeit umfasst Abruf, Zulassung und deterministische Synthese; Korpusladen, Modellgenerierung, Netzwerk und produktive IO sind ausgeschlossen. Wiederholungen und Übersetzungspaare sind abhängig; daraus folgt weder statistische Signifikanz noch eine Zusage zur Produktionslatenz. Hash-Vektoren bleiben bei 74/96 Modultreffern.
Lange Quellen: gemessener Faktenerhalt und sichtbare Grenzen
Eine neue Diagnose mit 96 Fällen kombiniert 8.000, 32.000, 128.000 und 256.000 Quellzeichen mit relevanten Belegen am Anfang, in der Mitte und am Ende, auf Deutsch und Englisch. Vier Szenarien prüfen Fakten, überlange Verneinungen, eine eingeschleuste Anweisung und fehlende Belege. Die gepaarte Studie enthält 576 Prompt-Vorbereitungen an der tatsächlichen Synthese- und Datenschutzgrenze. Die Längen sind Unicode-Zeichen, keine Modell-Tokens; Modellverständnis wird nicht gemessen.
Quellzeichen | Erhaltene positive Fakten |
|---|---|
8.000 | 12/12 |
32.000 | 12/12 |
128.000 | 12/12 |
256.000 | 8/12 |
Der Faktenerhalt bleibt vor und nach der Offenlegungsänderung bei 44/48. Alle vier Verluste liegen am Ende der 256.000 Zeichen langen Quellen und damit außerhalb der Scan-Grenze von 200.000 Zeichen. Der Kandidat übergibt unvollständige Auszüge und kontrollierte Auslassungsgründe an das Modell: Die Sichtbarkeit der Scan-Grenze steigt bei den 24 überlangen Fällen von 0/24 auf 24/24. Ob ein tatsächlich aufgerufenes Modell diese Grenzen für Nutzer verständlich kommuniziert, ist noch ungetestet. In 24 Kontrollen mit überlangen Verneinungen erscheint keine abgetrennte positive Aussage; die getestete Angriffsanweisung wird nie projiziert, und Fälle ohne Fakt erzeugen keinen positiven Treffer. Diese begrenzten Kontrollen belegen keine allgemeine Angriffssicherheit.
Diese Änderung zeigt keine Beschleunigung bei langen Quellen: Die gepaarten p50/p95-Zeiten der Prompt-Vorbereitung ändern sich von 16,042/36,081 ms auf 21,895/36,439 ms. Die Verarbeitung bleibt auf 200.000 Zeichen und 4.096 Quelleinheiten begrenzt.
Was die sechs Iterationen verändert haben
Ausgangsmessung reproduziert und Berichte zu fehlenden Nachweisen, Fehlern, Laufzeit und Wiederholungsstabilität korrigiert.
Unicode-Abgleich und Sprachfilterung getestet; drei deutsche Supportfehler bei der Modulzuordnung behoben.
Eine langsamere Optimierung der Tokenzählung verworfen; begrenzte Vorberechnung von Suchgewichten und Längennormalisierung beibehalten.
Kontrollierte Positionstests für lange Quellen und Negativkontrollen ergänzt.
Unvollständige Quellen und Auslassungsgründe an der Modell-Prompt-Grenze sichtbar gemacht.
Einen integrierten Kandidaten verworfen, der bei einer englischen Prozessfrage Quellenmarkierungen verlor. Eine konservative Erkennung deutscher Suchfragen stellt die englische Bewertung wieder her; der finale Vergleich aller Durchläufe besteht. Festgeschriebene Dokumentlinks werden gegen ihre Quelldateien geprüft.
260 gezielte Tests bestanden. Weitere 135 Fixture-Durchläufe erhalten die bisherigen Kontext- und Faktendiagnosen. Das Nachweispaket der sechs Iterationen enthält Quellhashes, akzeptierte und verworfene Kandidaten, Ausgaben und Reproduktionsschritte; GitHub-Zugriff ist erforderlich. Gemessen wurden lokale Code-Kandidaten; eine produktive Bereitstellung ist nicht nachgewiesen.
Die Methodik stützt sich auf begutachtete Forschung: Lost in the Middle, TACL 2024 motiviert wechselnde Belegpositionen; LongBench, ACL 2024 eine breitere Kontextbewertung; ALCE, EMNLP 2023 die getrennte Prüfung von Antwort- und Quellenqualität; Guidelines for Human-AI Interaction, CHI 2019 die Offenlegung von Fähigkeitsgrenzen. Die Arbeiten zertifizieren SupraAgent nicht. Ein Anspruch auf die weltweit beste Nutzererfahrung würde zusätzlich unabhängige Wettbewerbsvergleiche, Nutzertests, frische zurückgehaltene Fragen und überprüfte Prozessergebnisse erfordern.
Frühere Veröffentlichung und Diagramme
Die folgenden Studien und Diagramme dokumentieren die frühere Veröffentlichung zum Vergleich. Die oben angegebenen akzeptierten Ergebnisse ersetzen deren Messwerte zur Modulzuordnung und lokalen Laufzeit.
Stand: 11. November 2026. Der erweiterte SupraAgent-Benchmark zeigt getrennt, welche Quellen ankommen, welche Antwortmerkmale nachweisbar sind und wie lange lokale Komponenten benötigen. Neu sind 96 Modulfragen zu Aktionen, Aktivitäten, Prozessen und Support in Deutsch und Englisch.
Das neue Ergebnis: BM25 findet bei 93 von 96 Fragen mindestens eine Quelle aus dem angefragten Modul unter den ersten vier Treffern; deterministische Hash-Vektoren bei 74 von 96. Das misst Modulzuordnung, nicht die Richtigkeit oder Nützlichkeit der Antwort. Messbericht und Definitionen (GitHub-Zugriff erforderlich).
Drei Studien mit unterschiedlichen Aussagen
Studie | Umfang | Was sie zeigt |
|---|---|---|
Neue Kontext-Fixtures | 9 × 5 × 3 = 135 | Quellen-Recall und wörtliche Faktenpräsenz |
Neuer Modul-Replay | 96 × 2 × 3 = 576 | Modul-Hit@4, Quellenmarkierungen, lokale Laufzeit |
Frühere Modellantworten (08.11.2026) | 8 × 3 × 2 = 48 | Referenzüberlappung und Critic-Annahme |
Die neuen Läufe verwenden reale Abruf-, Zulassungs- und Synthesekomponenten mit einem lokalen Fixture-Index und deterministischer Extraktion. Es wurden dabei keine Modellanbieter aufgerufen und keine Geschäftsaktionen ausgeführt. Wiederholungen und Übersetzungspaare sind keine unabhängigen Stichproben. Die früheren Modellantworten werden als protokollierte Ergebnisse gezeigt und wurden hier nicht erneut erzeugt.
Kontextleistung: Quellenabruf ist messbar
Verfahren | Quellen-Recall (5 Fälle) | Faktenpräsenz (4 Fälle) |
|---|---|---|
BM25 | 65% | 50% |
Hash vectors | 65% | 50% |
Graph, 1 hop | 90% | 75% |
Graph, 3 hops | 100% | 100% |
Hybrid graph | 100% | 100% |
Drei Graph-Hops erreichen in diesen kleinen, selbst erstellten Fixtures alle erwarteten Quellen und Referenzfakten. Das Ergebnis ist ein Integrationstest. Wörtliche Faktenpräsenz prüft keine logische Folgerung; der Hash-Vektor-Vergleich ist kein modernes neuronales Embedding-Modell. Die synthetischen benchmark.invalid-Adressen sind Testkennungen. Vollständiger Fixture-Lauf · Fixture-Definitionen.
Eine effektive Langkontextkapazität wird hier nicht gemessen: Dafür müssten relevante Belege bei festgelegten Kontextlängen systematisch an Anfang, Mitte und Ende verschoben werden. Diese Unterscheidung folgt aus Lost in the Middle.
96 Fragen für Module und Support
Abgedeckt sind People, Teaching, Attema, Blogery, Store Connect, Deals, IoT Manage, Shortcuts, iAccelerator, Help Center, Templaterr und SupraAgent. Je Modul gibt es vier Fragetypen in zwei Sprachen: Aktionen mit Eingaben und Voraussetzungen, Aktivitäten und Status, Prozessschritte mit prüfbarem Ergebnis sowie Support bei Berechtigungsfehlern und fehlenden Angaben.
Beispiele: Wie ordne ich in Teaching einen Lernenden einer Gruppe zu? Welche Aktivitäten prüfe ich vor einem Geräteupdate in IoT Manage? Wie trenne ich beim Veröffentlichen in Blogery Lesen, Änderung, Freigabe und Ergebnisprüfung? Wie diagnostiziere und eskaliere ich einen Berechtigungsfehler in People, ohne Rechte zu umgehen? Die Fragen sind Diagnoseaufgaben; sie belegen keine erfolgreiche Ausführung.
Der Korpus enthält 1.037 vollständige Endpoint-Dokumentationsabschnitte. Beide Verfahren sehen dieselben Quellen; der Index wird bei jeder zweiten Wiederholung in umgekehrter Reihenfolge bereitgestellt. Generierte Eingabe- und Policy-Hinweise ersetzen weder vollständige Handler-Schemata noch aktuelle Mandantenberechtigungen. Alle Fragen und Bewertungsregeln · Antworten, Quellenlinks und Zeitmessungen.
Verfahren | Modul-Hit@4 | p50 (ms) | p95 (ms) | Antworten mit Quellenmarkierung |
|---|---|---|---|---|
BM25 | 93/96 (96,88%) | 22,372 | 35,196 | 95/96 |
Hash vectors | 74/96 (77,08%) | 92,306 | 121,854 | 96/96 |
Die Laufzeiten umfassen lokale Index-Wrapper-Erstellung, Abruf, Zulassung und deterministische Synthese; pro Verfahren sind es 288 Messungen. p50 und p95 sind Nearest-Rank-Perzentile. Korpusladen, Netzwerk, Modellgenerierung und Produktions-I/O sind ausgeschlossen. Die Werte sind keine Service-Latenzzusage.
Gruppe | BM25 | Hash vectors |
|---|---|---|
Deutsch | 45/48 | 38/48 |
Englisch | 48/48 | 36/48 |
Aktionen | 24/24 | 17/24 |
Aktivitäten | 24/24 | 19/24 |
Prozesse | 24/24 | 19/24 |
Support | 21/24 | 19/24 |
Alle drei BM25-Fehltreffer betreffen deutsche Supportfragen. Bei Hash-Vektoren erhält Help Center in diesem Set 0/8 Modul-Hits. Das sind konkrete Ansatzpunkte für die Weiterentwicklung, keine allgemeine Sprach- oder Supportqualitätsrangliste. Die Sprach- und Fragetypzeilen überlappen und dürfen nicht zusammengerechnet werden.
Antwortleistung: was Quellenlinks tatsächlich belegen
Alle beobachteten numerischen Quellenmarkierungen im Modul-Replay lassen sich einer zugelassenen Quellen-ID zuordnen: BM25 885/885, Hash-Vektoren 894/894 über alle Wiederholungen. Eine BM25-Antwort hat keine solche Markierung. Quellenauflösung ist keine semantische Quellenstützung. Antwortkorrektheit, Übersetzungsqualität, Supportnutzen und Prozesserfolg bleiben ohne unabhängige Bewertung ausdrücklich ungemessen.
Früherer Modelllauf | Whole-answer Token-F1 | Exact Match | Vom Critic angenommen |
|---|---|---|---|
BM25 | 4.51% | 0% | 16/16 |
BM25 + dense RRF | 6.02% | 0% | 14/16 |
Hybrid graph RRF | 7.19% | 0% | 15/16 |
Der frühere Lauf umfasst acht wiederverwendete öffentliche Entwicklungsfragen mit je zwei Wiederholungen. Bewertet wird die gesamte finale Antwort gegen eine kurze Referenz. Ausführliche richtige Antworten können deshalb geringe F1-Werte erhalten; umgekehrt belegt hohe Wortüberlappung keine Wahrheit. Zwei Quellen-/Referenzmehrdeutigkeiten bleiben dokumentiert. Die globale protokollierte Anbieter-Transportlatenz hat einen Median von 3.738,776 ms, ohne vollständige Orchestrierung. Sie ist nicht mit dem lokalen Modul-Replay vergleichbar. Historisches Originalprotokoll, Abschnitt complete_creator_accuracy_benchmark.
Vier Diagramme, vier klar begrenzte Messungen
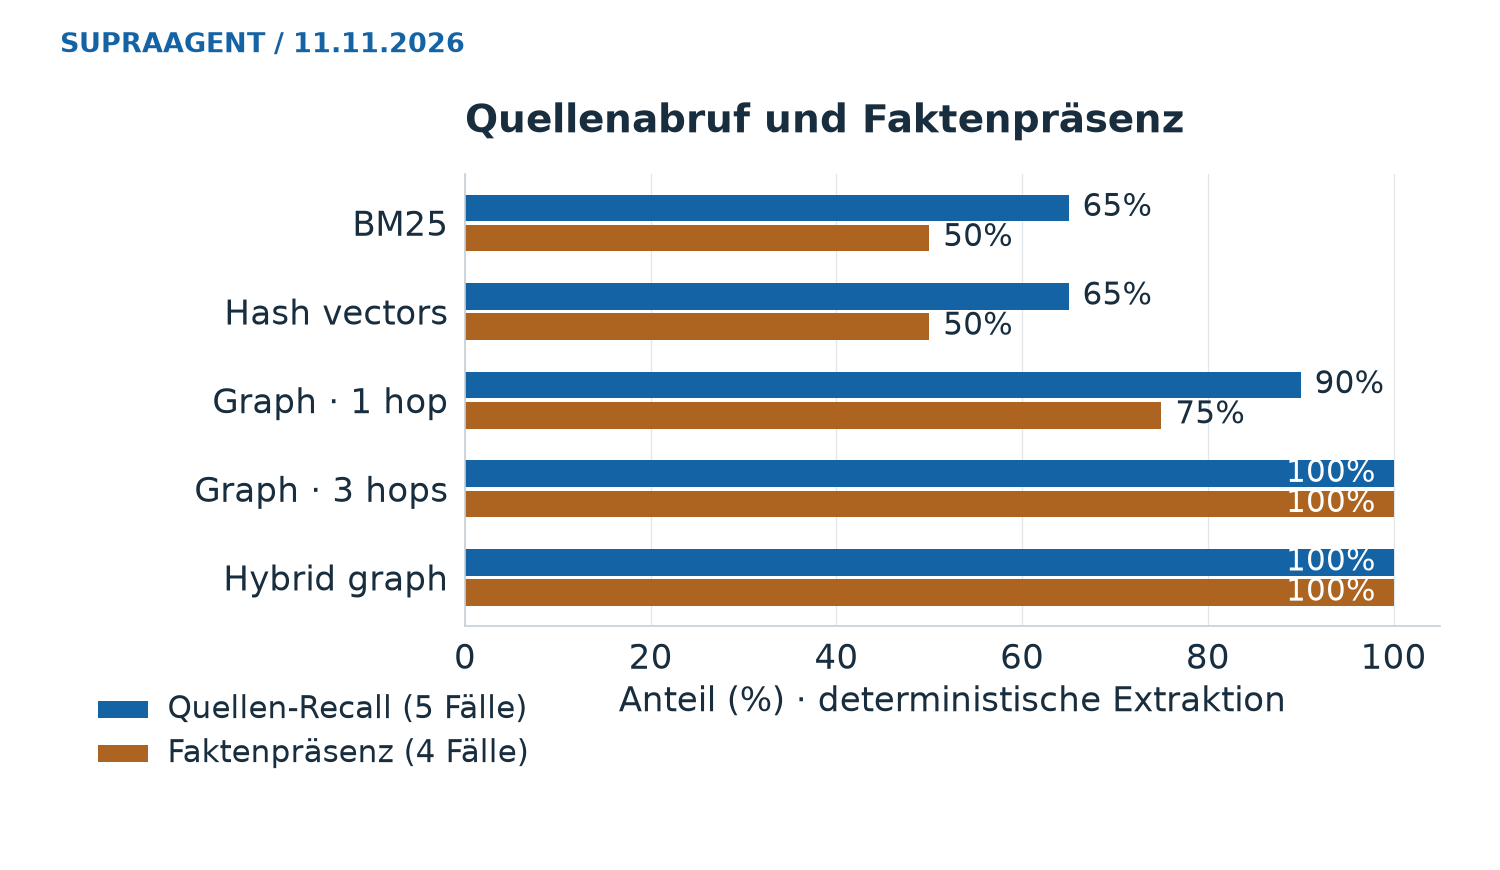
1. Kontext-Fixtures: Quellen-Recall über fünf annotierte Fälle und wörtliche Faktenpräsenz über vier Fälle. Keine semantische Genauigkeit.
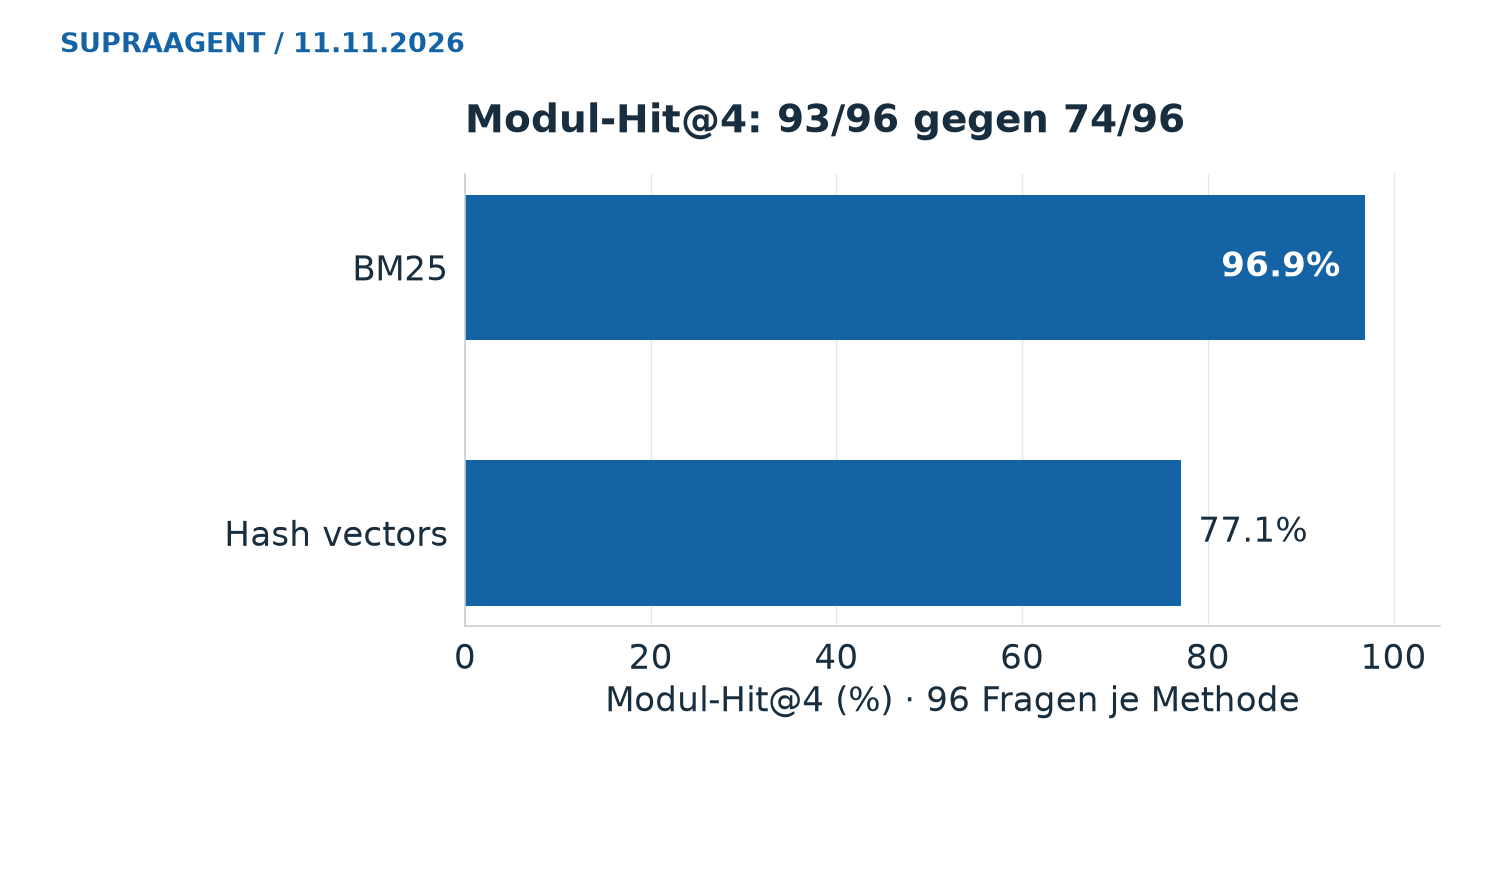
2. Modul-Hit@4: BM25 93/96, Hash-Vektoren 74/96. Mindestens eine Quelle aus dem Zielmodul; kein Nachweis der Antwortkorrektheit.
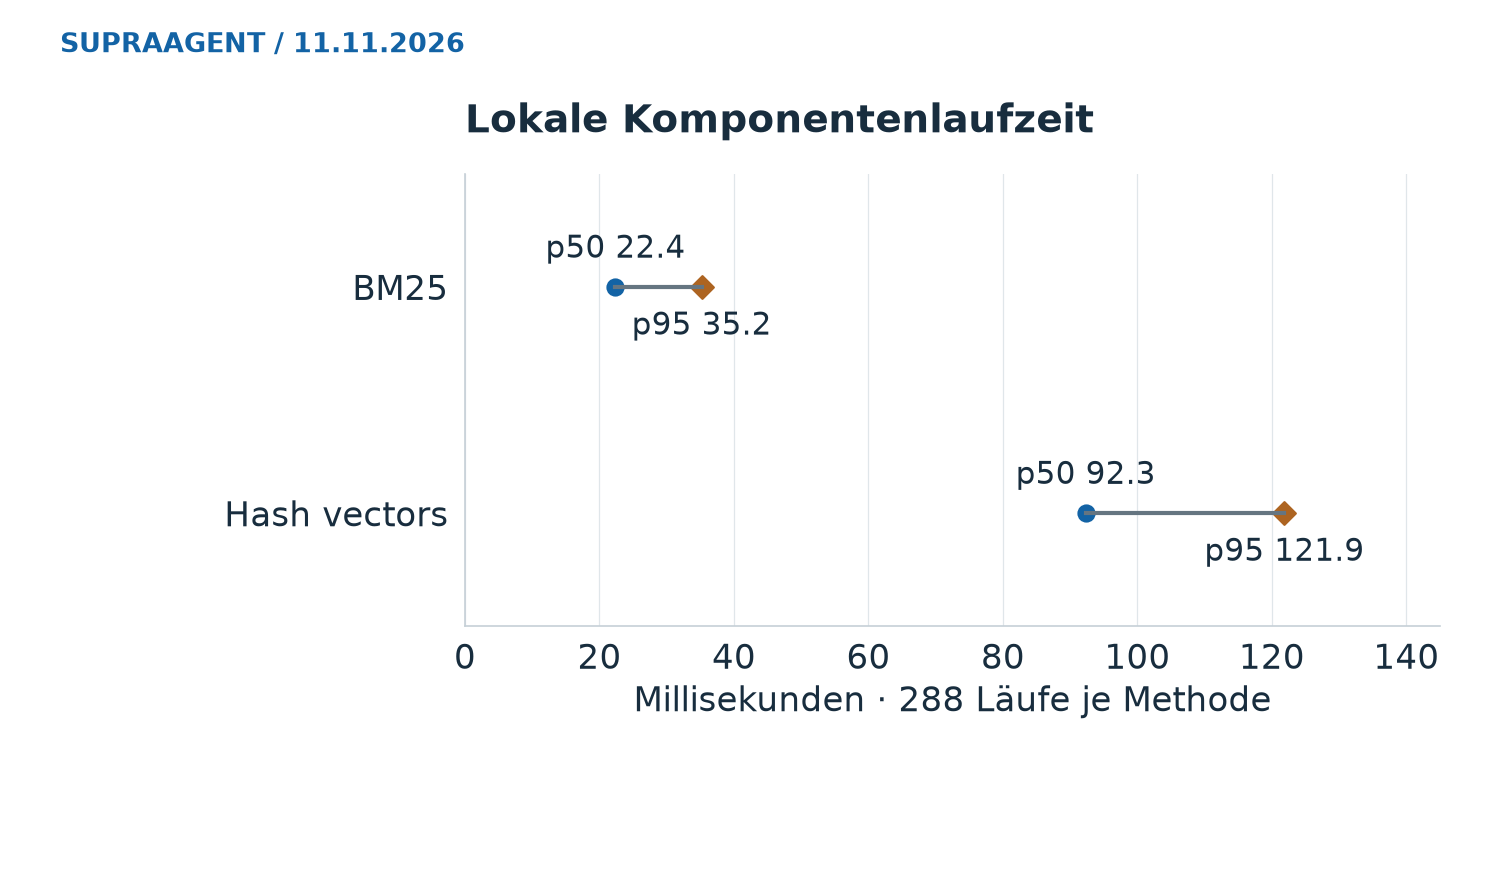
3. Lokale Laufzeit: BM25 p50 22,372 ms, p95 35,196 ms; Hash-Vektoren p50 92,306 ms, p95 121,854 ms. 288 Läufe je Verfahren, ohne Modell und Produktions-I/O.
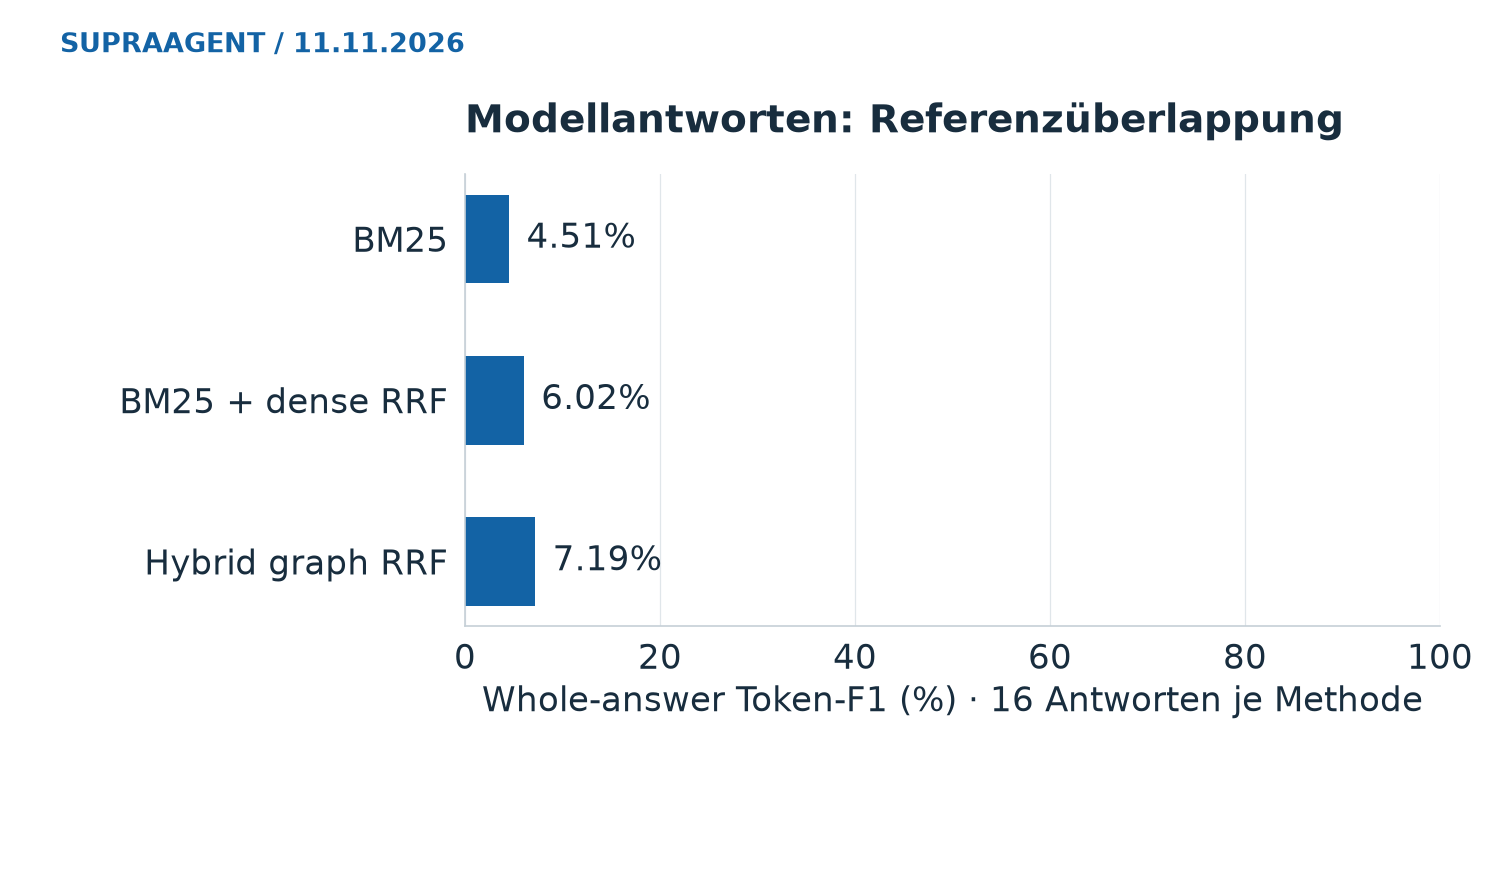
4. Historische Modellantworten: Whole-answer Token-F1 4,51%, 6,02%, 7,19%. Acht wiederverwendete Fragen, 16 Antworten je Verfahren; kein semantisches Genauigkeitsmaß.
Jede Abbildung lässt sich in voller Auflösung öffnen. Die Tabellen enthalten dieselben Werte als lesbaren Text.
Technische Nachweise und begutachtete Forschung
Die Implementierung ist über Abruf-Adapter und Arbiter, Synthesizer, Quellenzuordnung und den neuen Modul-Replay nachvollziehbar. Eingaben, Antworten, SHA-256-Prüfsummen und Prüfungen liegen im GitHub-Evidenzpaket; der Zugriff auf das Repository ist beschränkt.
Lewis et al. (NeurIPS 2020), Retrieval-Augmented Generation: Begründet die Verbindung von Quellenabruf und Generierung. Für SupraAgent werden beide Stufen getrennt gemessen.
Liu et al. (TACL 2024), Lost in the Middle: Zeigt Positionsabhängigkeit bei langen Kontexten. Deshalb ist Quellen-Recall kein Nachweis eines effektiv nutzbaren langen Kontextfensters.
Gao et al. (EMNLP 2023), ALCE: Unterscheidet Antwort- und Zitationsqualität. Eine auflösbare Quellen-ID ersetzt keine Prüfung, ob die Quelle die Aussage trägt.
Yang et al. (EMNLP 2018), HotpotQA: Liefert Mehrschrittfragen und annotierte unterstützende Fakten. Die früheren öffentlichen Entwicklungsfragen sind kein versiegelter Kundentest.
Yao et al. (ICLR 2025), tau-bench: Prüft regelgebundene Werkzeugnutzung anhand des erreichten Datenbankzustands. Für echte Prozessleistung braucht SupraAgent entsprechende Ergebnisprüfungen.
Der HotpotQA-Datensatz auf Hugging Face ergänzt den Paper-Nachweis. Diese Publikationen begründen die Methodik; sie sind keine Begutachtung oder Zertifizierung von SupraAgent. Der technische Implementierungsnachweis besteht aus Code, Laufbelegen und Prüfungen. Die Ergebnisse aus den Papers sind keine SupraAgent-Benchmarkwerte.
Was vor einer belastbaren Produktfreigabe noch fehlt
Erforderlich sind unabhängig bewertete Antworten und Zitationsstützung, neue mandantenspezifische Holdout-Fragen, kontrollierte Langkontexttests und isolierte Prozessläufe mit vorher/nachher geprüftem Zustand. Bis dahin erlaubt dieser Benchmark konkrete Regressions- und Abrufdiagnosen. Er belegt keine allgemeine Genauigkeit, keinen erfolgreichen Live-Prozess und keine Überlegenheit gegenüber anderen Agenten. Reproduktion, Grenzen und vollständige Quellen.